Sukurti automatizuotą darbo procesą (angl. workflow), kuris sklandžiai veikia antradienį, nėra sunku. Daug sunkiau pastebėti, kad ketvirtadienį jis tyliai nustojo veikti.
„AAI Labs“ kuriame automatizuotus procesus naudodami „n8n“ ir „Windmill“ platformas. Jie atlieka įvairias užduotis – nuo klientų duomenų sinchronizavimo iki sąskaitų apdorojimo ir dirbtiniu intelektu paremto duomenų praturtinimo.
Kai šios automatizacijos iš bandomųjų projektų tapo gamybinėmis sistemomis, susidūrėme su gerai pažįstama problema. Platformos pranešdavo, jei vykdymo metu sugesdavo konkretus mazgas (angl. node). Tačiau jos nepranešdavo, jei darbo procesas apskritai nebuvo paleistas arba buvo pažymėtas kaip sėkmingas, nors negrąžino jokių rezultatų.
Šiame straipsnyje pasakojame, kaip sukūrėme minimalaus funkcionalaus stebėjimo (angl. Minimal Viable Monitoring, MVM) sistemą, kuri užpildo šią spragą nenaudojant brangių stebėjimo sprendimų.
20 % spraga integruotose stebėjimo priemonėse
Tiek „n8n“, tiek „Windmill“ turi galingas integruotas stebėjimo priemones. Vykdymo žurnalai (angl. execution logs), pakartotinio vykdymo logika, klaidų darbo srautai ir įspėjimai padengia apie 70–80 % to, ko reikia gamybinėje aplinkoje.
Vis dėlto, išanalizavę abi platformas, pastebėjome tą pačią spragą. Nei „n8n“, nei „Windmill“ natūraliai neaptinka situacijų, kai suplanuotas darbo procesas apskritai neįvyksta. Jei nustoja veikti cron trigeris arba procesas įstringa vykdymo metu, bet nesukelia klaidos, platforma apie tai nepraneša. Paprasčiausiai nėra įvykio, kurį būtų galima užregistruoti.
Būtent šiuose likusiuose 20 % slypi didžiausia rizika.
Jei sustoja duomenų praturtinimo procesas, klientų duomenys pasensta. Jei neįvyksta sąskaitų apdorojimas, vėluoja mokėjimai. Todėl mums reikėjo sprendimo, kuris užtikrintų matomumą abiejose platformose ir leistų visų vykdymų informaciją kaupti vienoje vietoje.
Minimalus funkcionalus stebėjimas (MVM): architektūra
Užuot diegę sudėtingą APM sprendimą, pasirinkome lengvą kelių sluoksnių architektūrą. Ji remiasi tuo, ką platformos jau siūlo, o papildomą stebėjimą įdiegia tik ten, kur jo iš tikrųjų trūksta.
Sistema susideda iš penkių pagrindinių dalių:
- Centralizuotas klaidų nukreipimas (angl. centralized error router). Vienas „n8n“ klaidų darbo srautas surenka visų prijungtų darbo srautų klaidas, jas suformatuoja ir siunčia į „Slack“ kanalą
#flow-alerts. Pranešime pateikiamas darbo srauto pavadinimas, klaidos santrauka, sugedęs mazgas ir tiesioginė nuoroda į vykdymą. „Windmill“ tokio mechanizmo neturi, todėl kiekviename darbo sraute naudojame atskirą klaidų tvarkytoją, kuris siunčia tokio pat formato pranešimus. - Bendras vykdymų žurnalas. Kiekvienas darbo srautas į bendrą
flow_executionslentelę įrašo vykdymo pradžią, o jam pasibaigus arba įvykus klaidai tą įrašą atnaujina. - Tylių gedimų aptikimas (angl. „Watchdog“). Pagal grafiką veikiantis procesas tikrina, ar nėra darbo srautų, kurie nebuvo paleisti arba liko įstrigę vykdymo metu.
- Veiklos įvykių registravimas. Darbo srautai taip pat siunčia domeno lygio įvykius, pavyzdžiui,
ReportGeneratedarInvoiceProcessed, į papildomąflow_eventslentelę. Taip registruojamas ne tik pats vykdymas, bet ir jo rezultatas. - „Dead-Man’s Switch“. Išorinis veikimo patikrinimo signalas leidžia aptikti visos automatizavimo platformos gedimus dar prieš jiems sukeliant platesnių problemų.
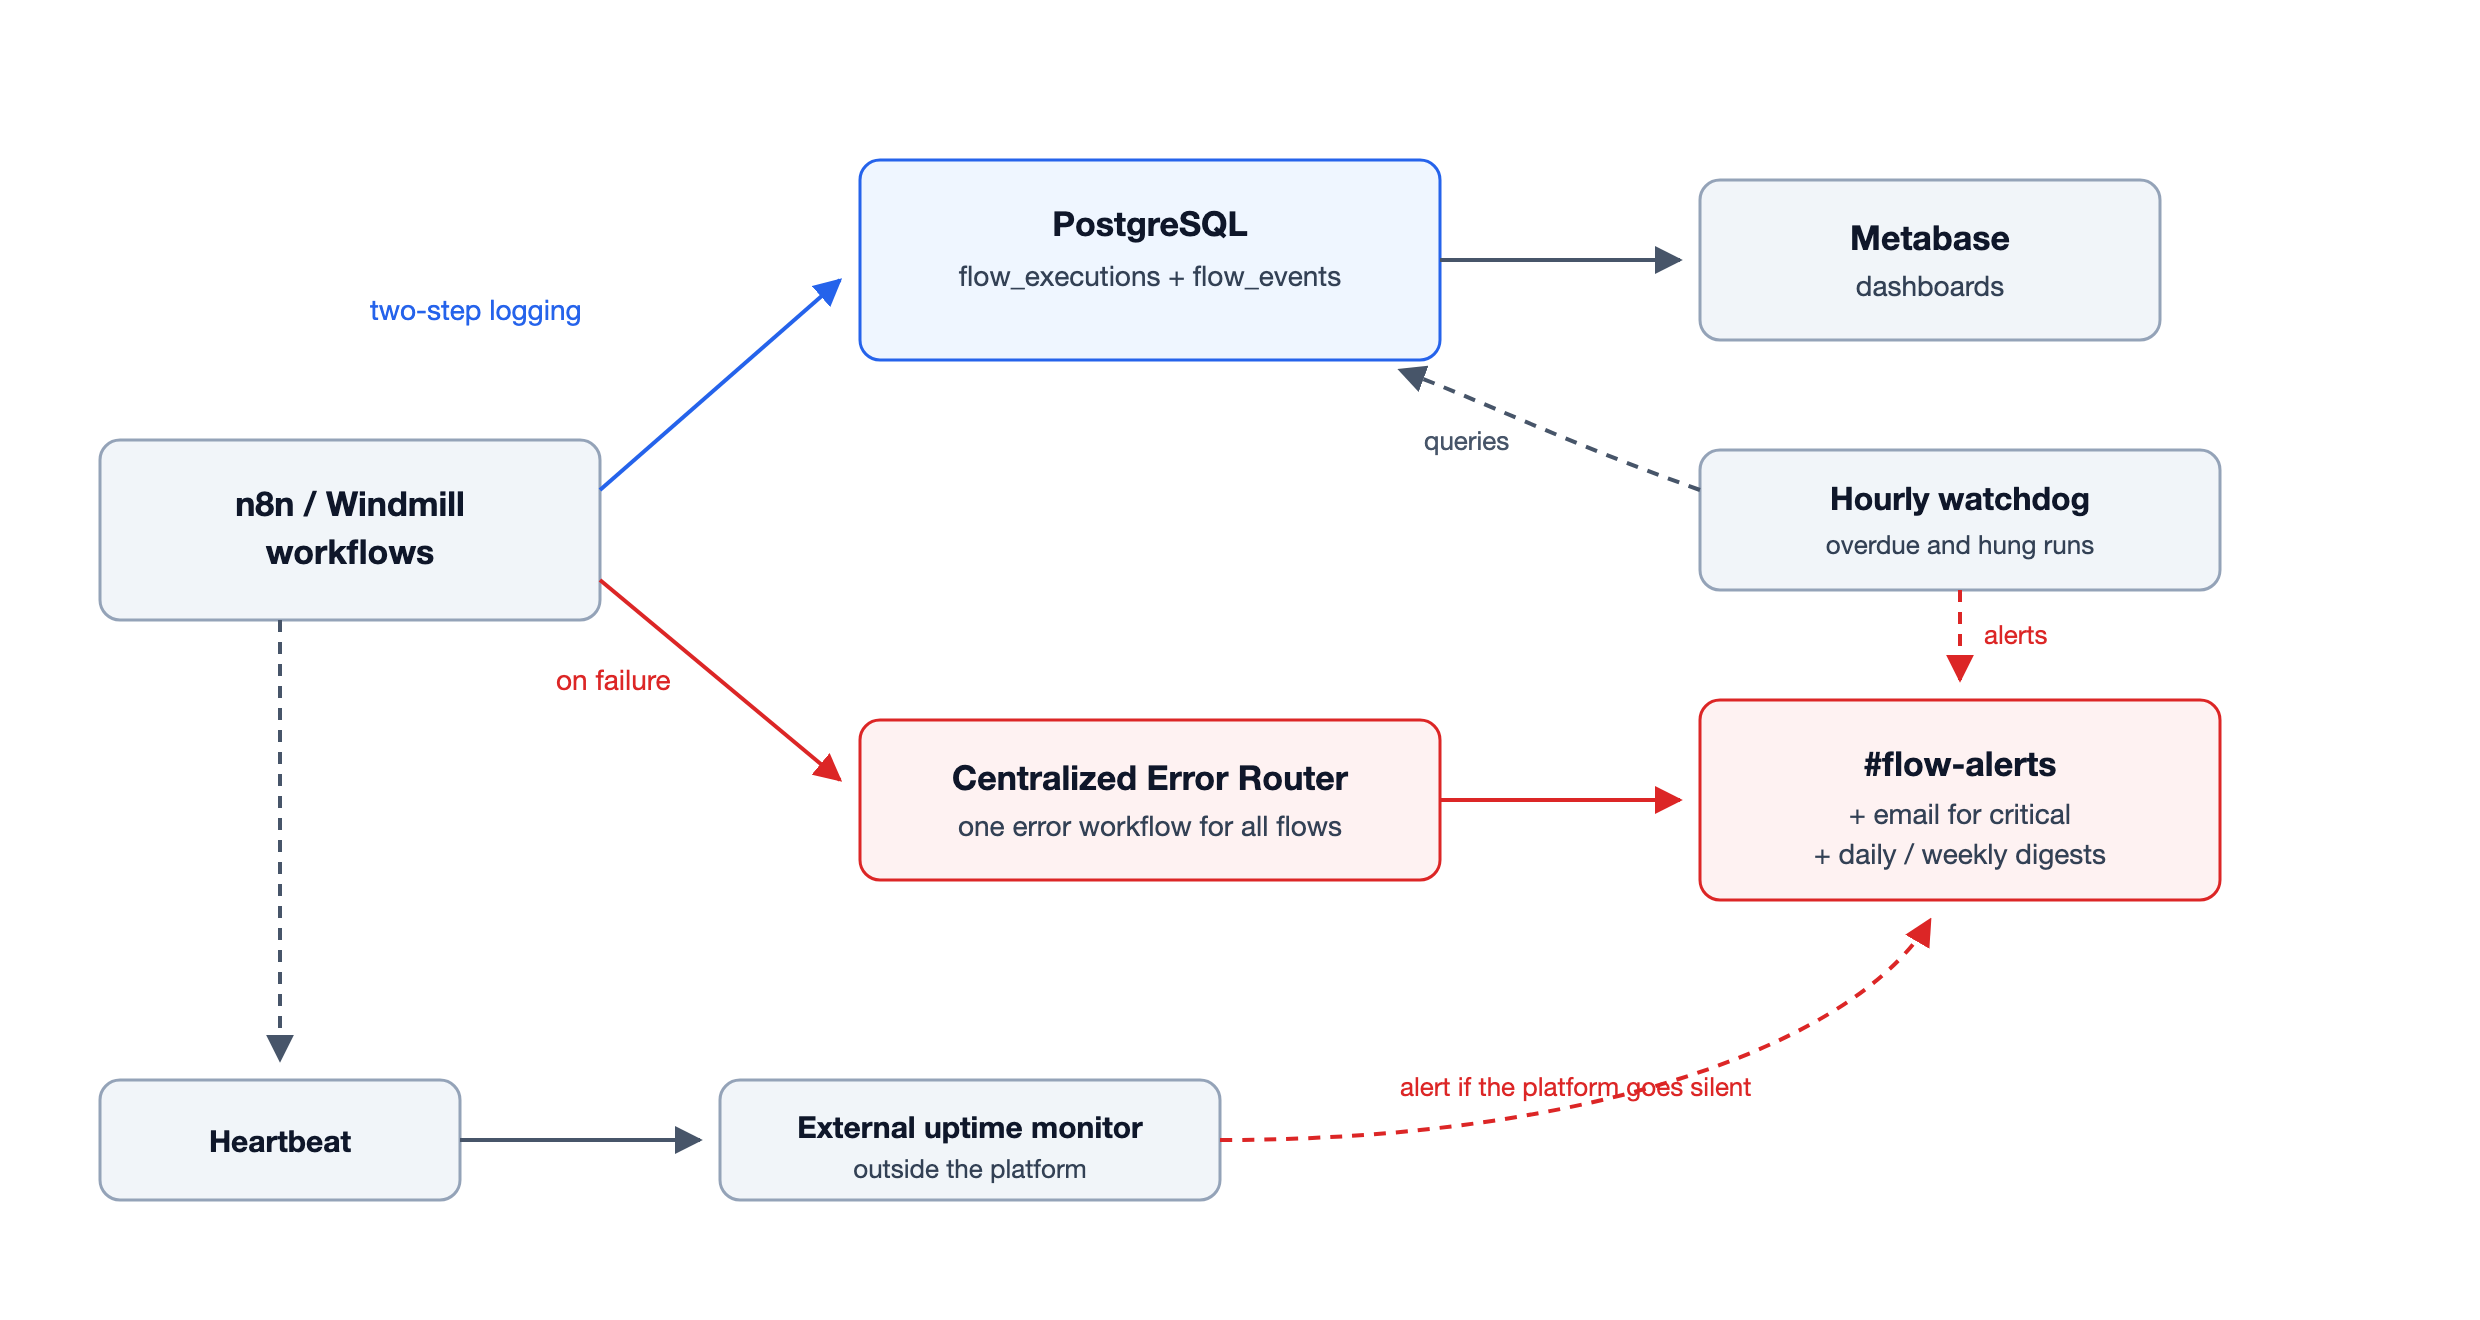
Šį sprendimą kūrėme sąmoningai. Pirmiausia išnaudojome tai, ką jau suteikia naudojamos platformos, o papildomą stebėjimą diegėme tik ten, kur iš tikrųjų buvo spragų.
Kalbant apie diegimą, stebėjimo sistemos projektavimą baigėme 2026 m. vasario pabaigoje. Centralizuotas klaidų stebėjimas gamybinėje aplinkoje pradėjo veikti jau kovo 4 d., maždaug po savaitės. Vykdymų žurnalai, įvykių registravimas ir „Metabase“ informacinės lentelės buvo diegiami etapais per kitus tris mėnesius.
Vienas žurnalas, du mechanizmai
Visos sistemos pagrindas – viena flow_executions lentelė, saugoma „PostgreSQL“ analitinėje duomenų bazėje.
Kiekvienas darbo srautas, nesvarbu, ar jis vykdomas „n8n“, ar „Windmill“ platformoje, pradėdamas darbą sukuria naują įrašą, o baigęs jį atnaujina. Tam naudojami HTTP mazgai, kurie duomenis įrašo per „Hasura GraphQL“ sluoksnį.
Lentelėje saugoma pagrindinė informacija apie kiekvieną vykdymą: flow_id, run_id, status (started, success, error, timeout), started_at, finished_at, error_message, error_node, platform ir parent_flow_id, kuri leidžia susieti pakaitinių darbo eigų vykdymus su pagrindiniu procesu.
Svarbiausias šio sprendimo elementas – dviejų etapų įrašymas.
Vos prasidėjus vykdymui sukuriamas pradinis įrašas. Jei darbo eiga vėliau užstringa ir niekada nepasiekia paskutinio atnaujinimo žingsnio, tas pradinis įrašas vis tiek lieka duomenų bazėje. Todėl užtenka surasti vykdymus, kurie per ilgai išlieka started būsenoje, ir iš karto matyti įstrigusius procesus.
Remiantis šia viena lentele, „Metabase“ informacinės lentelės pateikia bendrą abiejų platformų vaizdą. Tam nereikia nei „Grafana“, nei „Prometheus“, nei sudėtingos įmonės lygio žurnalų infrastruktūros.
„Metabase“ rodinyje, sukurtame tiesiogiai iš flow_executions lentelės, matomas vykdymų skaičius pagal darbo srautą, sėkmės ir klaidų rodikliai bei vykdymo trukmės statistika.
„Watchdog“ – tai, ko nepastebi įprasti stebėjimo įrankiai
Įprastas klaidų tvarkymas veikia tik tada, kai darbo srautas iš tikrųjų paleidžiamas ir vykdymo metu įvyksta klaida. „Watchdog“ užpildo šią spragą. Jis periodiškai paleidžiamas pagal grafiką, peržiūri aktyvių suplanuotų darbo srautų sąrašą, apskaičiuoja, kada kiekvienas jų turėjo būti paskutinį kartą įvykdytas, ir patikrina flow_executions lentelę.
Jei numatyto vykdymo įrašo nėra arba užduotis vėluoja ilgiau nei nustatyta saugumo atsarga (maždaug dvigubai ilgiau už įprastą vykdymo intervalą), sistema sugeneruoja įspėjimą. Toks rezervas padeda sumažinti klaidingų pavojaus signalų skaičių.
Papildomai naudojame ir dead man’s switch mechanizmą. Pagal grafiką siunčiamas paprastas „širdies plakimo“ (angl. heartbeat) signalas į išorinę veikimo stebėjimo sistemą. Jei visa automatizavimo platforma nustoja veikti, išorinis stebėtojas apie tai praneša dar prieš komandai pastebint, kad „Slack“ kanale nebesirodo naujų pranešimų.
Tačiau egzistuoja ir trečias tylių gedimų tipas, kurio nei „Watchdog“, nei dead man’s switch aptikti negali. Tai situacija, kai darbo eiga baigiama sėkmingai, tačiau grąžina neteisingus arba tuščius rezultatus. Tokius atvejus galima aptikti tik pačiame darbo sraute. Reikia tikrinti išvesties struktūrą ir rezultatų kiekį bei siųsti įspėjimą, jei apdorotų įrašų skaičius tampa nulinis arba reikšmingai nukrypsta nuo įprasto lygio.
Tą pačią idėją taikome ne tik gedimams. Specialus nukrypimų stebėtojas analizuoja mūsų viešųjų konkursų peržiūros procesą ir ieško neįprastų įvesties duomenų apimčių. Taip aptinkami nukrypimai, kurie nesukelia techninių klaidų, bet vis tiek gali rodyti problemą.
| Tylus gedimas | Kas įvyko | Kaip tai aptinkame |
|---|---|---|
| Niekada nesuveikė | Grafikas pažeistas, darbo srautas deaktyvuotas | „Watchdog“ tikrina flow_executions dėl vėluojančių užduočių |
| Įstrigo vykdymo viduryje | Nėra gedimo, bet nėra ir užbaigimo | Eilutės įstrigo started būsenoje ilgiau nei numatyta trukmė |
| „Sėkmingai užbaigta“ su klaidingais duomenimis | API grąžino kodą 200 su tuščiais arba neteisingais duomenimis | Darbo eigos viduje atliekamas išvesties formos ir skaičiaus tikrinimas |
| Platforma neveikia | Pats orkestratorius sugedo | „Dead-man’s switch“ per išorinį veikimo laiko stebėjimo įrenginį |
Kur patenka įspėjimai
Visi abiejų platformų gedimų pranešimai siunčiami į vieną „Slack“ kanalą – #flow-alerts. Visų įspėjimų formatas vienodas. Juose pateikiamas darbo srauto pavadinimas, laiko žyma, klaidos pranešimas, sugedęs mazgas ir nuoroda į konkretų vykdymą.
Vienas kanalas reiškia vieną vietą, kur ieškoma informacijos. Visa istorija saugoma vienoje vietoje, todėl nekyla klausimų, kur turėjo būti išsiųstas konkretus pranešimas. Žinoma, ne kiekvienas gedimas yra vienodai svarbus. Todėl kiekvienam darbo srautui priskiriamas kritiškumo lygis, nuo kurio priklauso, kaip bus siunčiamas pranešimas.
| Lygis | Kriterijai | Nukreipimas | Pavyzdys |
|---|---|---|---|
| 🔴 Kritinis | Pagrindinis verslo procesas, duomenų praradimo rizika | Nedelsiant siunčiamas „Slack“ įspėjimas ir el. laiškas, automatinis pakartojimas | Sąskaitų apdorojimas, klientų duomenų sinchronizavimas |
| 🟡 Įspėjimas | Nekritinis gedimas arba pakartojimas pavyko | Pranešimas „Slack“ kanale | Savaitinių ataskaitų generavimas |
| 🔵 Informacija | Sėkmingi vykdymai, veiklos rodikliai | Tik kasdienė apžvalga | Planuojami veikimo patikrinimai |
Paprasta taisyklė tokia: jei žmogus apie problemą turi sužinoti per penkias minutes, tai kritinis įvykis. Jei galima palaukti iki ryto, pakanka įspėjimo. Jei nereikia jokių veiksmų, tai informacinis pranešimas.
Be šių įspėjimų, kartą per savaitę el. paštu siunčiama vykdymų santrauka, sudaryta pagal flow_executions lentelės duomenis. Taip komanda gali greitai įvertinti sistemos būklę net neatidarydama stebėjimo skydelio.
Keletas skaičių iš mūsų sistemos:
Klaidų stebėjimas veikia nuo 2026 m. kovo. Iš pradžių jis buvo integruotas į vienuolika gamybinių darbo srautų, įskaitant sąskaitų surinkimą ir viešųjų konkursų peržiūrą. Šiuo metu stebime jau 24 aktyvius darbo srautus.
Per įprastą savaitę sugeneruojami keli gedimų pranešimai – vidutiniškai maždaug vienas per dieną. Didžiausias vienkartinis incidentas įvyko sugedus bendrai funkcijai. Per mažiau nei minutę sistema išsiuntė kelias dešimtis įspėjimų. Būtent tokiose situacijose vieningas kanalas ir vienodas pranešimų formatas pasiteisina geriausiai.
Toliau pateikiamas tikras pranešimas iš #flow-alerts kanalo (vykdymo nuoroda pašalinta). Jis susijęs su incidentu, aprašytu kitame skyriuje.
*Workflow Failed*
━━━━━━━━━━━━━━━━━━
 *Workflow:*  EU project statistics - insight generation inner loop
 *Time:*      2026-07-06T10:00:43Z
 *Error:*     The resource you are requesting could not be found
              (404 - ERROR_ROW_DOES_NOT_EXIST)
 *Failed at:* Baserow: get row
 *Execution:* [nuoroda į n8n vykdymą]
 *Run ID:*    36703
Kada sistema pasiteisino
Vieną liepos pirmadienio rytą, apie 10 val., sugedo mūsų savaitinis ES finansavimo paraiškų statistikos apdorojimo procesas.
Praėjus mažiau nei dešimčiai sekundžių, #flow-alerts kanale pasirodė įspėjimas. Jame buvo nurodytas darbo srautas, sugedęs mazgas ir tikslus klaidos aprašymas.
Kodėl tai buvo svarbu?
Šis procesas veikia visiškai automatiškai ir generuoja savaitines analitines įžvalgas apie finansavimo kvietimus. Gedimą sukėlė užklausa į įrašą, kurio sistemoje jau nebebuvo. Kadangi problema buvo nuolatinė, kiekvienas kitas suplanuotas vykdymas būtų pasibaigęs lygiai ta pačia klaida.
Be stebėjimo sistemos apie problemą greičiausiai būtume sužinoję tik po kelių savaičių. Kažkas būtų paklausęs, kodėl nebegaunamos savaitinės įžvalgos, ir tuomet būtų tekę pradėti tyrimą nuo nulio, neturint jokių užuominų. Mūsų atveju viskas įvyko kitaip. Apie gedimą sužinojome per kelias sekundes. Įspėjime jau buvo visa informacija, reikalinga problemai atkurti ir diagnozuoti. Pataisymas buvo parengtas ir įdiegtas po trijų dienų.
Gedimo aptikimas užtruko vos kelias sekundes. Jei jo nebūtume pastebėję, būtume turėję savaites tyliai neveikiantį procesą ir rizikavę prarasti vartotojų pasitikėjimą.
Ką išmokome
Gamybinio lygio automatizacija – tai ne tik veikiantys darbo srautai. Ne mažiau svarbu žinoti, kada jie nustoja veikti.
Mūsų sukurta minimali funkcionalaus stebėjimo sistema padėjo pereiti nuo pavienių, sunkiai stebimų automatizacijų prie sprendimo su centralizuotais įspėjimais ir bendru visų platformų matomumu.
Šis metodas nėra susietas su konkrečia platforma. Jis sąmoningai išlieka paprastas ir remiasi principu, kad stebėjimas turi būti numatytas dar projektuojant sistemą, o ne diegiamas vėliau, kai jau atsiranda problemų.