2026 m. liepą Berkeley Function Calling Leaderboard (BFCL), viena dažniausiai cituojamų DI įrankių vertinimo platformų, stipriausiu open-weight modeliu įrankių naudojimui atlikti įvardijo Qwen3 235B, kurio tikslumas siekė apie 88,5%. Ši informacija – naudingas atspirties taškas. Tačiau šis vertinimas kiekvieną panaudotą įrankį vertina atskirai ir nieko nesako apie tai, kiek kainuoja modelio naudojimas, ar jis išlieka nuoseklus per ilgą užduotį ir kokios įrangos jam reikia.
Šios spragos svarbiausios, kai DI agentus kuriate su open-weight modeliais, kuriuos galite talpinti savo infrastruktūroje. Agentų klaidos retai susijusios su prastai parašytu tekstu. Dažniausiai jie panaudoja ne tą įrankį, išsigalvoja parametrą arba supainioja kontekstą penkiolikos žingsnių užduoties viduryje. Kiekviena klaida reiškia pakartotinį bandymą arba žmogaus įsikišimą, o abu klaidų taisymo metodai kainuoja ir laiką, ir pinigus.
Modelį patikimu daro skirtumas tarp to, ar jis teisus vieną kartą, ar kiekvieną kartą. Originaliame τ-bench tyrime GPT-4o iš pirmo bandymo atliko apie 61% mažmeninės prekybos klientų aptarnavimo užduočių. Kai tą pačią užduotį reikėjo sėkmingai atlikti visus aštuonis kartus, rezultatas nukrito žemiau 25%.
Todėl per mūsų liepos mini projektus viena komanda uždavė praktinį klausimą: kuriuo atvirųjų svorių modeliu pigiausia pasitikėti įmonei, kuri naudoja savo agentus?
Kodėl kaina už tokeną yra netinkamas įvertis
Pagrindinis komandos rodiklis yra kaina už sėkmingą užduotį: kiek kainuoja vienos užduoties tokenai, padalyta iš to, kaip dažnai modelis užduotį atlieka. Suklydęs modelis turi bandyti dar kartą, todėl tikroji vienos atliktos užduoties kaina yra didesnė, nei rodo kainoraštis. Jei vienas bandymas kainuoja 0,03 USD, o modelis sėkmingas 60% atvejų, kiekviena sėkminga užduotis iš tikrųjų kainuoja 0,05 USD.
Kad modelius būtų galima palyginti, kiekviena kaina skaičiuojama tai pačiai standartinei agento užduočiai: apie 15 panaudotų įrankių, maždaug 60 000 įvesties ir 6 000 išvesties tokenų.
Perėjimas nuo tokenų skaičiavimo prie kainos už rezultatą parodo, kiek iš tikrųjų kainuoja atlikta užduotis.
Kaip buvo atrinkti 13 modelių
Komanda pradėjo nuo compar:IA, viešos Prancūzijos vyriausybės DI palyginimo paslaugos, kurios 2026 m. birželio atnaujinime buvo įvardinti 113 modelių. Šį sąrašą komanda naudojo tik kaip katalogą, ne kaip reitingą, ir pritaikė keturis filtrus:
- Tik open-weight modeliai, kad modelį būtų galima talpinti savo infrastruktūroje.
- Viena dabartinė pagrindinė versija iš kiekvienos modelių šeimos, o ne kiekvienas tarpinis leidimas.
- Integruotas įrankių naudojimo palaikymas.
- Bent keli paskelbti agentų vertinimų rezultatai.
Liko 13 modelių. Kiekvienas buvo įvertintas pagal viešus šaltinius: įrankių iškvietimo tikslumas pagal Berkeley Function Calling Leaderboard (BFCL); patikimumas pagal BFCL kelių žingsnių testus, testą, ar modelis žino, kada įrankio nenaudoti, ir τ²-bench; kainos pagal tiekėjų kainoraščius. Prie kiekvieno skaičiaus nurodytas šaltinis ir duomenų gavimo data.
Praktinė pastaba: kai kurie iš šių modelių išleisti su „pusiau atviromis” licencijomis, kurių komercinės sąlygos skiriasi. Licenciją patikrinkite prieš diegdami.
Kiek iš tikrųjų kainuoja agento užduotis (2026 m. liepos duomenys)
Tai pačiai standartinei užduočiai pigiausias modelis kainuoja 0,008 USD, o brangiausias 0,127 USD, t. y. 16 kartų daugiau. Štai aštuoni modeliai su išsamiais kainų duomenimis, surikiuoti pagal kainą už sėkmingą užduotį:
| # | Modelis | Kaina už sėkmingą užduotį | Patikimumas | Reikalinga įranga |
|---|---|---|---|---|
| 1 | Qwen3 32B | 0,008 USD | 81,2 % | Vienas GPU (80 GB) |
| 2 | MiniMax M3 | 0,028 USD | 88,9 % | Kelių mazgų klasteris |
| 3 | DeepSeek V4 Pro | 0,039 USD | 80,7 % | Kelių mazgų klasteris |
| 4 | GLM-4.5-Air | 0,040 USD | 46,5 % | Vienas GPU (80 GB) |
| 5 | Qwen3 235B | 0,046 USD | 83,9 % | Vienas serveris (8×80 GB) |
| 6 | GLM-5 / 5.1 | 0,053 USD | 89,7 % | Kelių mazgų klasteris |
| 7 | Kimi K2 / K2.6 | 0,057 USD | 80,9 % | Kelių mazgų klasteris |
| 8 | Mistral Large 3 | 0,127 USD | 30,7 % | Vienas serveris (8×80 GB) |
Išsiskiria trys dalykai.
Pigiausias modelis kartu yra ir geriausias pagal vertę. Qwen3 32B yra mažas modelis, veikiantis viename 80 GB GPU. Viena užduotis kainuoja mažiau nei centą, o patikimumas siekia 81,2%.
Aukštas patikimumas nebūtinai brangus. MiniMax M3 pasiekia 88,9% patikimumą, artimą sąrašo viršūnei, už 0,028 USD už užduotį.
Brangiausias modelis yra mažiausiai patikimas. Mistral Large 3 kainuoja 0,127 USD už užduotį, o jo patikimumas siekia vos 30,7%, mažiausiai iš aštuonių.
Vienas teisingas iškvietimas dar nereiškia patikimumo
Įrankių panaudojimo tikslumas parodo, ar modelis pasirenka tinkamą funkciją ir teisingai užpildo argumentus. Patikimumas parodo, ar jis tai daro per visą kelių žingsnių užduotį, žino, kada įrankio nepanaudoti, ir nuosekliai sėkmingai atlieka užduotį ją kartojant.
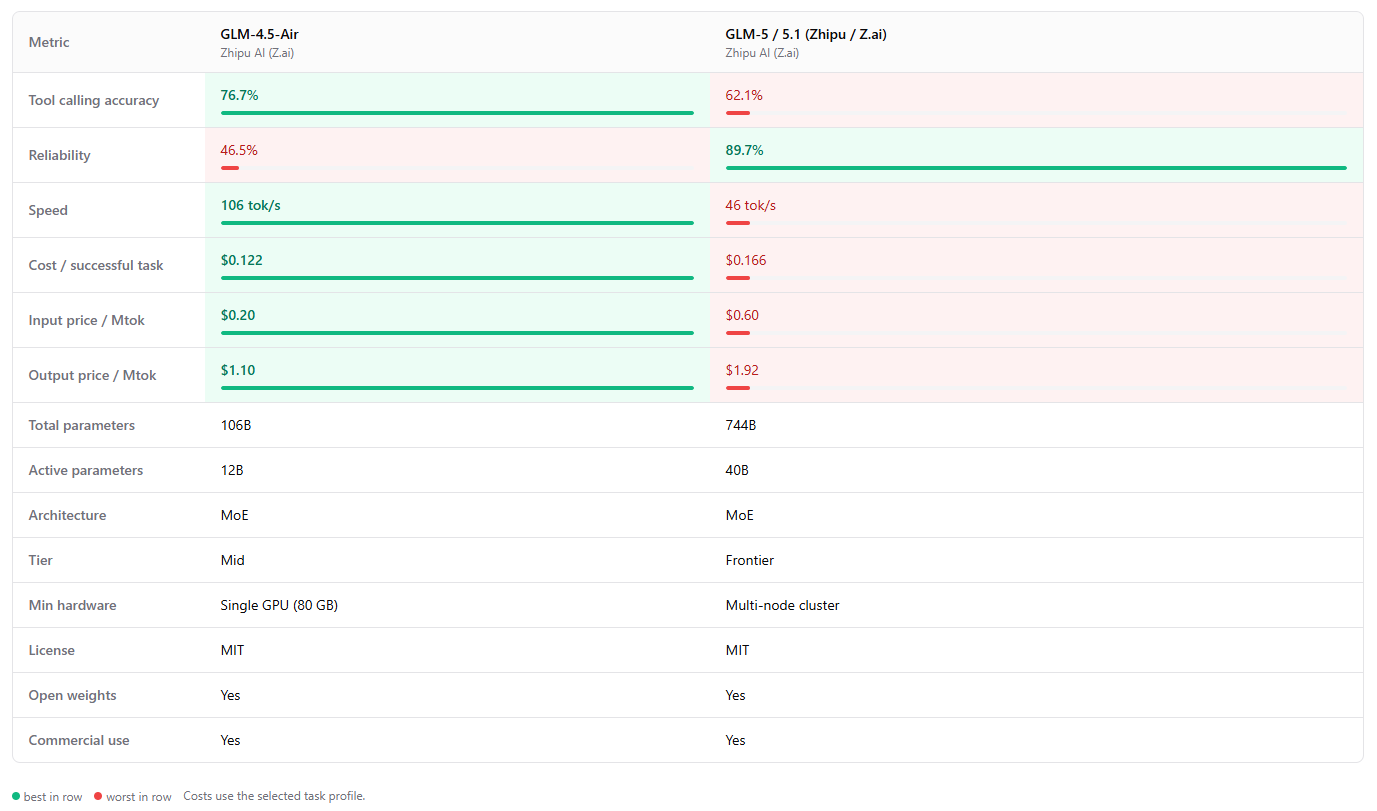
GLM-4.5-Air įrankių panaudojimo tikslumas siekia 76,7%, bet patikimumas – tik 46,5%. GLM-5 yra priešingas atvejis: įrankių iškvietimo tikslumas 62,1%, bet tai patikimiausias palyginimo modelis, 89,7%.
Rinkdamiesi tik pagal įrankių panaudojimo rezultatus galite pasirinkti GLM-4.5-Air ir pamatyti, kaip agentas sugenda užduoties viduryje. Rinkdamiesi tik pagal patikimumą galite praleisti modelį, kuris gerai atlieka trumpas, vieno žingsnio užduotis. Todėl palyginime vertinami abu rodikliai.
Nė vienas modelis nelaimi visko
| Kategorija | Nugalėtojas | Rezultatas |
|---|---|---|
| Pigiausias už užduotį ir geriausias pagal vertę | Qwen3 32B | 0,008 USD už užduotį |
| Patikimiausias | GLM-5 / 5.1 | 89,7 % |
| Geriausias įrankių iškvietimas | Qwen3 235B | 88,5 % |
| Greičiausias | Llama Nemotron 70B | 277 tokenai per sekundę |
Greičiausias modelis nėra pigiausias, o tiksliausias nėra patikimiausias. Prieš žiūrėdami į reitingą, nuspręskite, kuris rodiklis jūsų agentui svarbiausias.
Pradėkite nuo turimos įrangos
Daugumai įmonių pirmasis klausimas yra ne tai, kuris modelis geriausias, o tai, kurį iš jų jos iš tikrųjų gali naudoti.
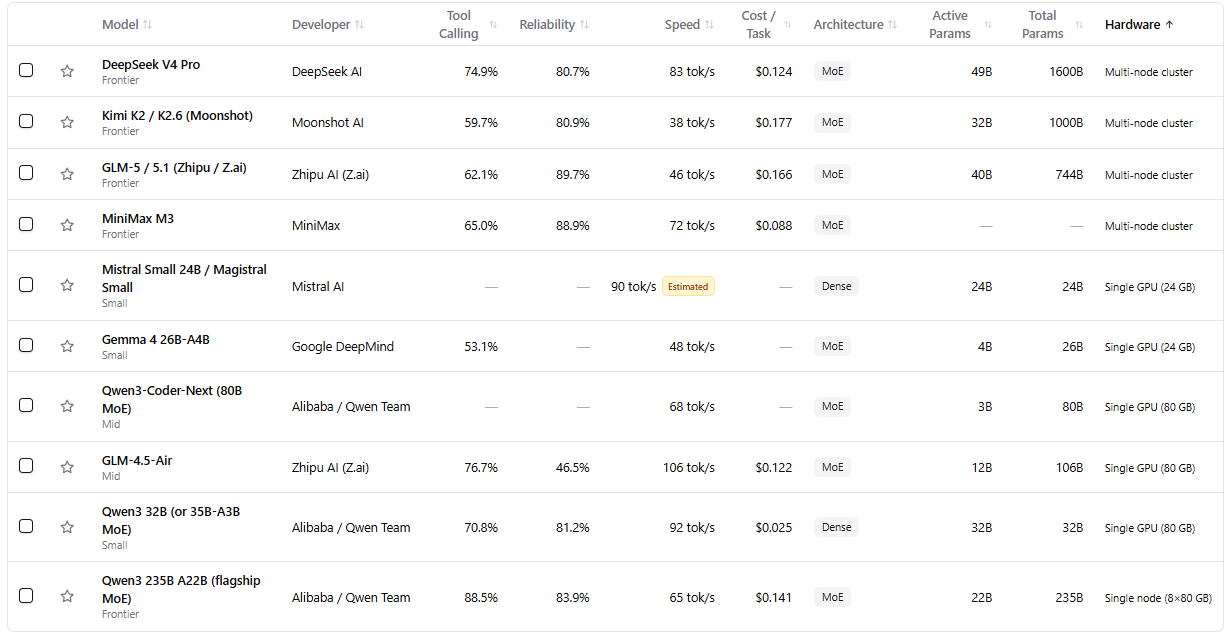
- Vienas GPU (80 GB): aiškus pasirinkimas yra Qwen3 32B. GLM-4.5-Air veikia ta pačia įranga, bet viena užduotis kainuoja penkis kartus daugiau, o patikimumas gerokai mažesnis.
- Vienas serveris (8 × 80 GB GPU): Qwen3 235B kainuoja 0,046 USD už užduotį, pasiekia 83,9% patikimumą ir turi geriausią įrankių iškvietimo rezultatą palyginime. Mistral Large 3 reikia panašios įrangos, jis kainuoja beveik tris kartus daugiau ir yra gerokai mažiau patikimas.
- Kelių GPU klasteris arba API: MiniMax M3 yra pigiausias labai patikimas variantas. Jei patikimumas svarbesnis už kainą, patikimiausias modelis yra GLM-5, kuris kainuoja maždaug dvigubai daugiau.
Ilgesnės užduotys keičia pasirinkimus. Kaina auga su kiekvienu tokenu, o kiekvienas papildomas žingsnis yra dar viena galimybė nepatikimam modeliui suklysti. Ilgai veikiantiems agentams patikimumas turėtų būti svarbesnis už kainą.
Ką šie skaičiai gali ir ko negali pasakyti
- Rezultatai paimti iš viešų vertinimų ir tiekėjų kainoraščių, o ne iš mūsų pačių bandymų. Komandos indėlis yra išsibarsčiusių šaltinių sudėjimas į vieną vietą, papildant juos kaina ir įranga.
- Viešų vertinimų rezultatai yra geriausias atvejis. Modeliai vis dažniau derinami prie gerai žinomų testų, todėl su savo užduotimis tikėkitės prastesnių rezultatų.
- Ne kiekvieną modelį apima kiekvienas vertinimas. Kai kurie patikimumo rezultatai remiasi vienu šaltiniu, kiti trimis.
- Modeliai ir kainos keičiasi kas mėnesį. Šie duomenys atspindi 2026 m. liepos 10 d. būseną.
Kaip pasirinkti modelį savo agentui
- Įvertinkite užduoties dydį. Apytiksliai suskaičiuokite, kiek įrankių ir tokenų reikia vienai užduočiai.
- Lyginkite kainą už sėkmingą užduotį, o ne kainą už tokeną.
- Atsirinkite tai, ką galite naudoti: turimą įrangą ir jums priimtinas licencijos sąlygas.
- Prieš apsispręsdami, išbandykite atrinktus modelius su savo užduotimis. Vieši rezultatai susiaurina pasirinkimą, o galutinį sprendimą lemia jūsų darbo procesai.
Modelis, kuris pigus už tokeną, bet dažnai klysta, nėra pigus agentas. Šiame palyginime pigiausias modelis, kuriuo galima pasitikėti, buvo mažas, viename GPU veikiantis modelis, o ne vienas didžiųjų pažangiausių modelių. Vieši vertinimai padeda sudaryti trumpąjį sąrašą, bet galutinis pasirinkimas turėtų priklausyti nuo bandymų su jūsų pačių užduotimis.